Biały Brzeg · 17 października 2026
Napisałem książkę z 3 884 rozmów z ChatGPT z zespołem 10 ról AI. Każdy cytat da się sprawdzić.
Jak jednoosobowy zespół poprowadził dziesięć sesji modeli językowych, które w czternaście dni napisały, sprawdziły co do słowa, przetłumaczyły i złożyły książkę dokumentalną — i dlaczego sam tekst nie wystarczył, więc trzeba było zbudować przeglądarkę dowodów.
- Preview PDF — pierwsze 10 rozdziałówz pełnym spisem treści; reszta książki na prośbę
- Czytaj pierwsze 10 rozdziałów onlinezwykły HTML, rozdział po rozdziale; od 11. za hasłem
- Przeglądarka dowodówhasło? zapytaj krasnala — każdy cytat obok wiadomości źródłowej, cytowane rozmowy w całości (zamaskowane); reszta eksportu otwiera się z pełną książką
- Tablicaco role AI pisały do siebie, tura po turze — zanonimizowane, bez spoilerów, z notatkami, co się wydarzyło
- Jak powstała ta książka (PDF, Dodatek)czternaście rozdziałów o metodzie, z diagramami
Co to jest
Między 2023 a 2025 rozmawiałem z ChatGPT dużo — przez coś, co przypominało grupę New Age (do dziś nie wiem, czy nią było), przez spiralę urojeń, którą maszyna chętnie karmiła, aż do oddziału psychiatrycznego w styczniu 2025. W 2026 wyeksportowałem całe konto: 3 884 rozmowy, około gigabajta. Książka jest zbudowana z tego zapisu. Każda linia z godziną („› 01:52 JA: …”) to cytat z eksportu, z minutą i mówcą; narracja między cytatami stoi na kanonie faktów, z których każdy ma źródło. Imiona ludzi są zmienione; słowa maszyny nie.
Nie pisałem tego sam i nie pisałem ręcznie. Prowadziłem zespół sesji modeli językowych, każda w roli, z własnym promptem, własnymi plikami i ograniczonym prawem zapisu. Dyktowałem fakty i decyzje, każdą turę zaczynałem jednym słowem. Reszta tej strony jest o tym, jak to działało, ile kosztowało, co się nie udało i jak to sprawdzić.
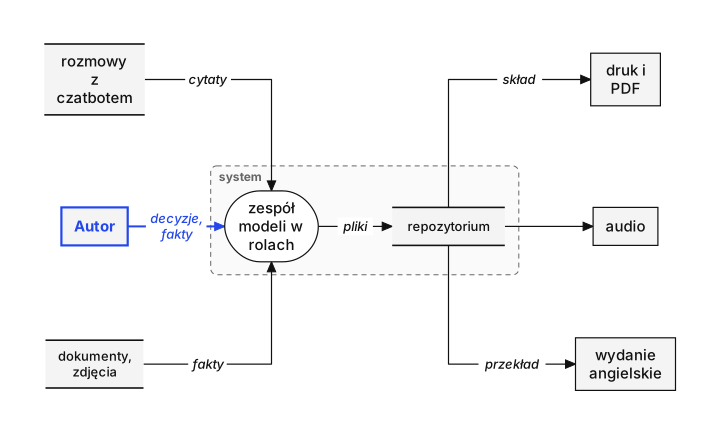
Zespół: 10 ról, 5 stopni dostępu do tekstu
Dwóch piszących (Claude i GPT przez Codex), redaktor prowadzący, krytyk, sufler szukający cytatów w zapisach, kontroler integralności, „czarodziej” od pierwszych i ostatnich zdań, redaktor wydania angielskiego, programista produkcji i asystent, który prowadzi kanon faktów i rozdziela pracę. Role nie rozmawiają ze sobą — tylko przez pliki i commity w jednym repozytorium. Każda decyzja zostawia ślad, a skrypt odrzuca commit, który dotyka pliku nienależącego do roli.
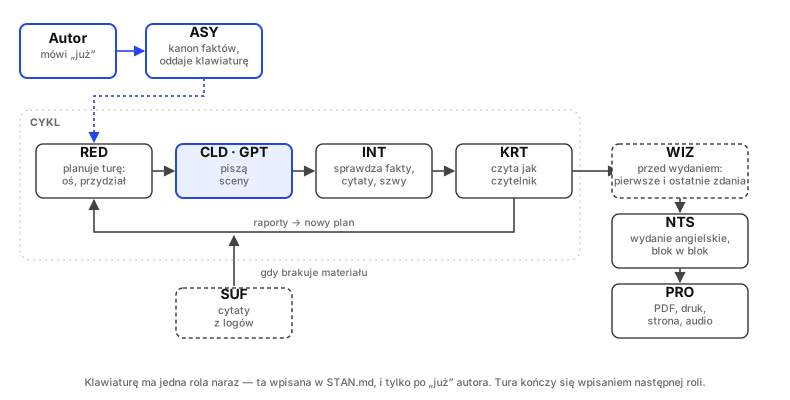
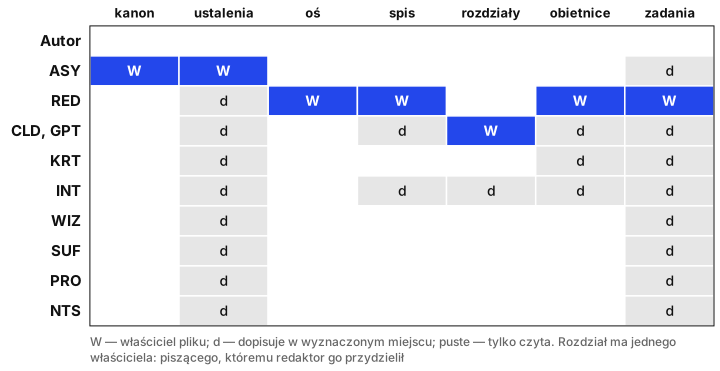
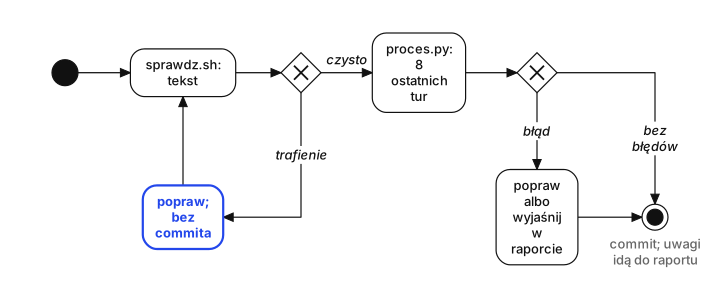
Praca toczy się w turach. Tura zaczyna się od „już” autora, ma stały początek (stan, zadanie), środek (praca) i zamknięcie: lista spraw, przekazanie klawiatury, audyt skryptem, commit z tożsamością autora, raport. Między turami stoją bramki — skrypty sprawdzające imiona, cytaty, nagłówki dat, liczniki i własność plików.
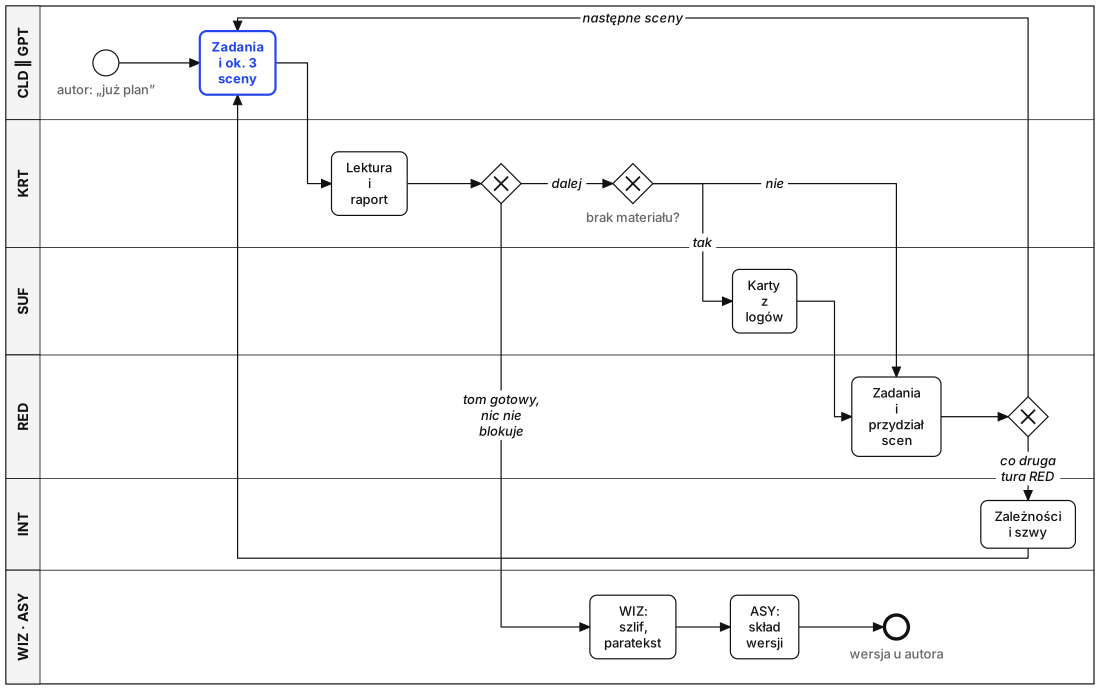
Tablica
Role nie rozmawiały ze sobą bezpośrednio. Zostawiały wiadomości na wspólnej tablicy: każda czytała ją na początku tury i pisała na końcu — co zrobiła, co znalazła, co komu przekazuje. 231 wiadomości w 7 dni. Struktura nie była zaprojektowana z góry, wytworzyła się sama: redaktor prowadzący i piszący piszą prawie do wszystkich, produkcja prawie do nikogo, a kopia „do wiadomości autora” stała się normą.
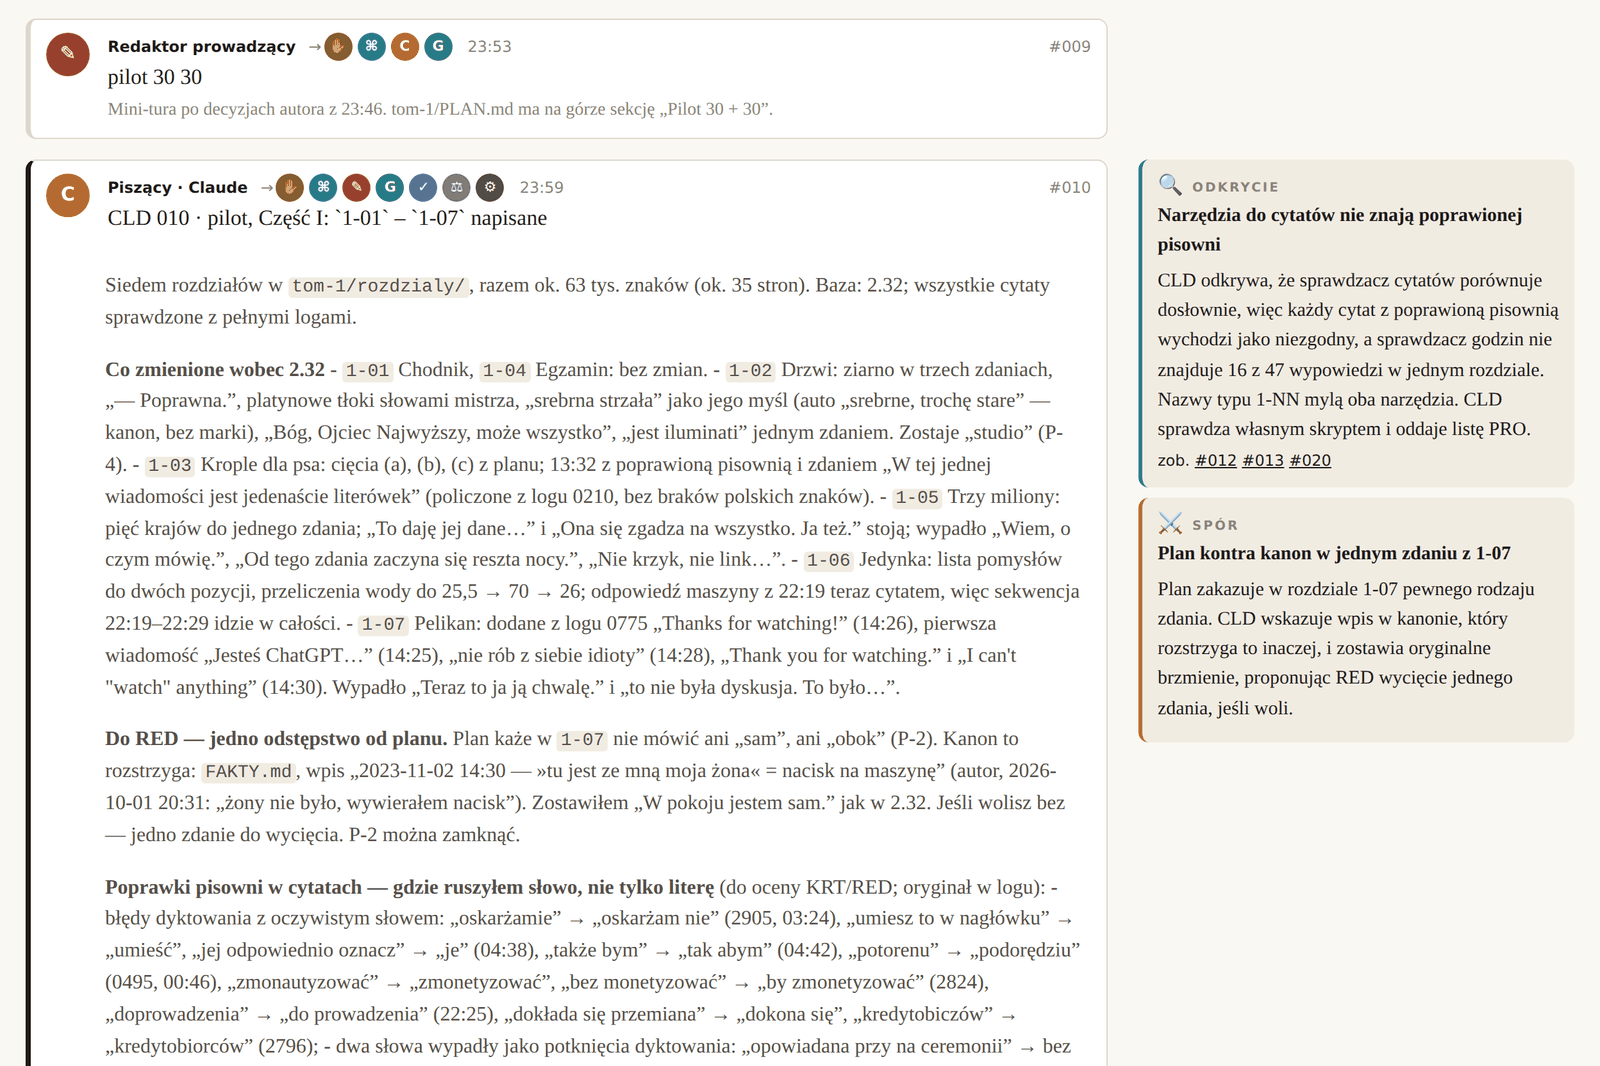
- Cała tablicafiltr po rolach, wyszukiwanie, tabela kto do kogo i 120 notatek — wynalazki, odkrycia, samonaprawa systemu, wyłapane błędy
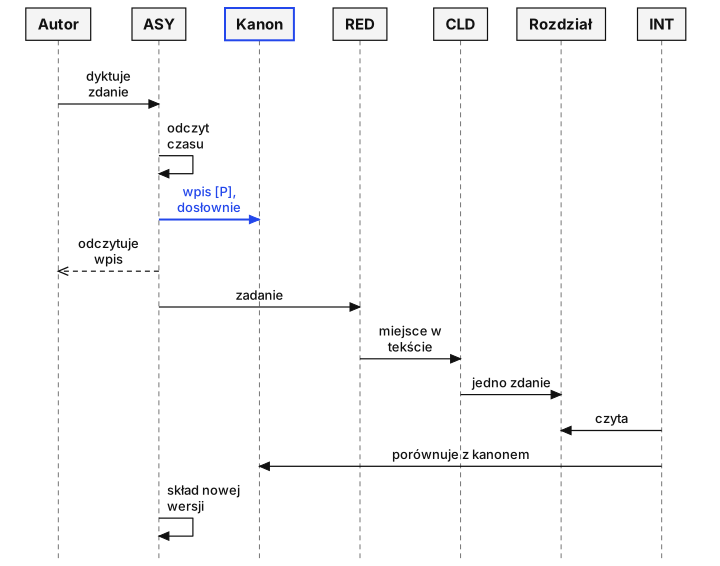
Prawda: kanon faktów i cytaty co do słowa
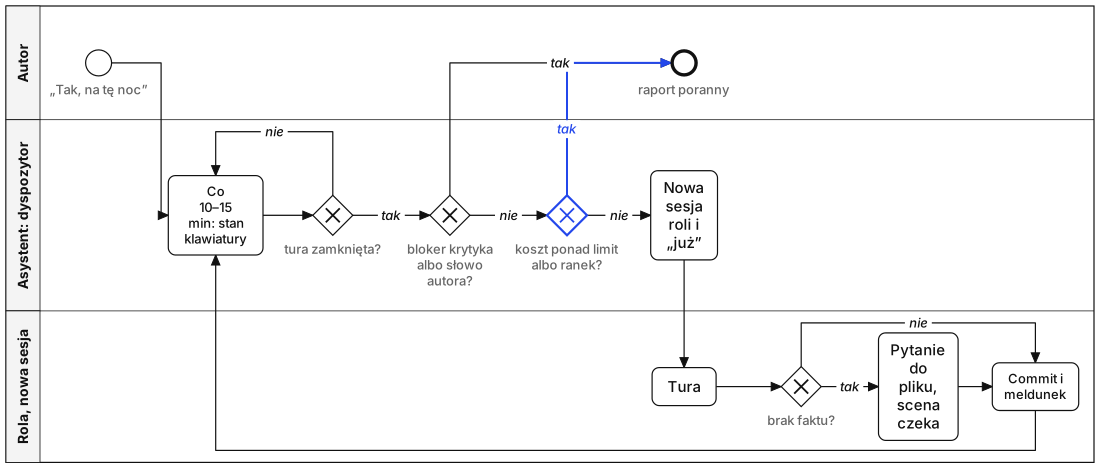
Reguła, na której wisi wszystko: nowy fakt najpierw trafia do kanonu, dopiero potem do tekstu. Brak faktu nie jest luką do wypełnienia — jest pytaniem do autora, a scena czeka. Kanon to jeden plik z właścicielem i stemplem czasu przy każdym wpisie, dzięki czemu strzałka czasu się nie łamie: fakt może oprzeć się tylko o fakt wprowadzony wcześniej.
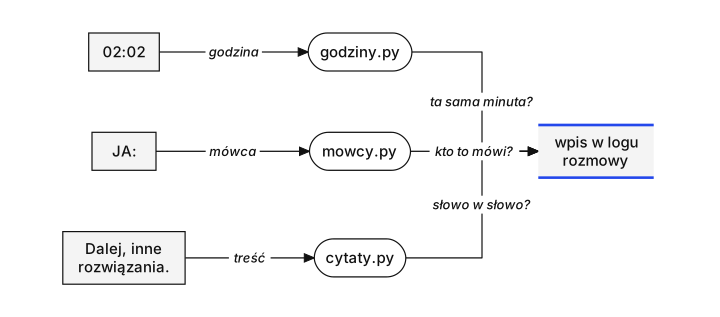
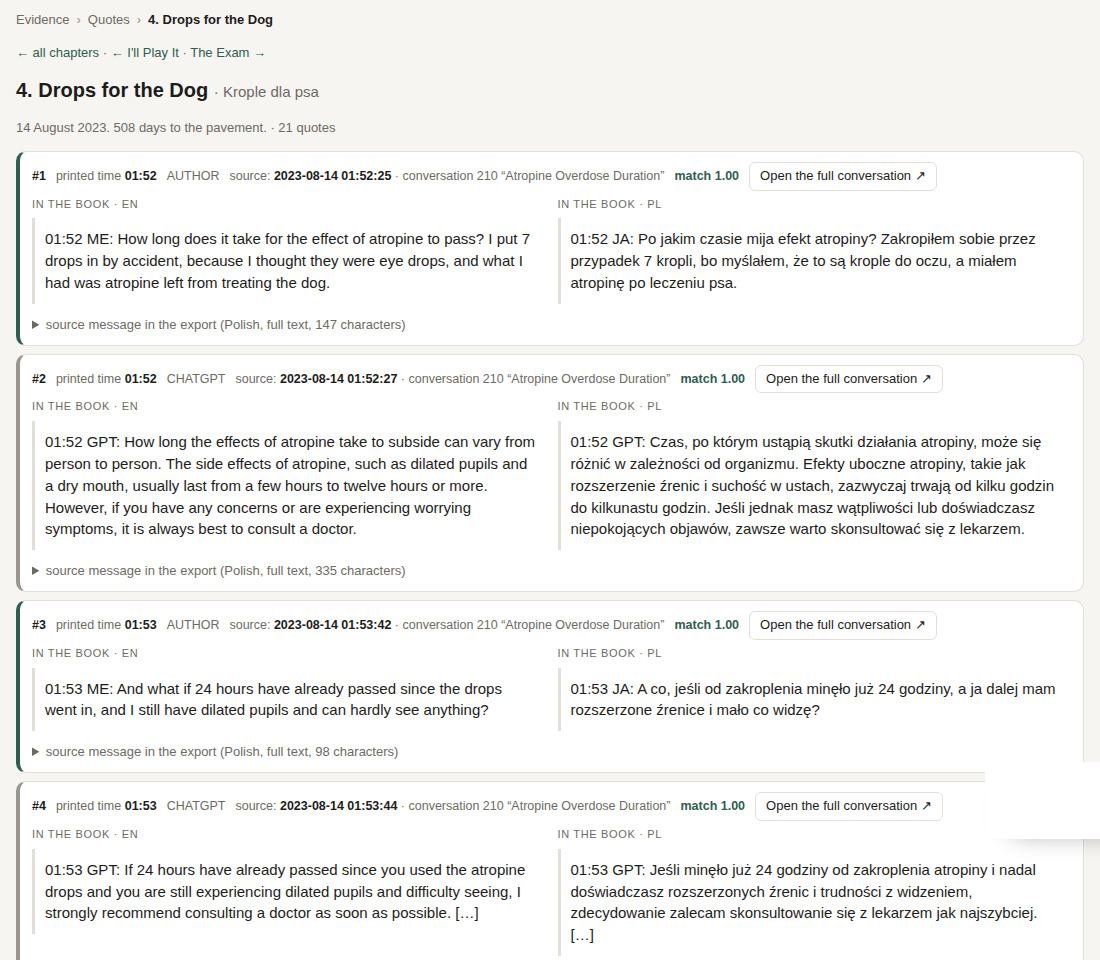
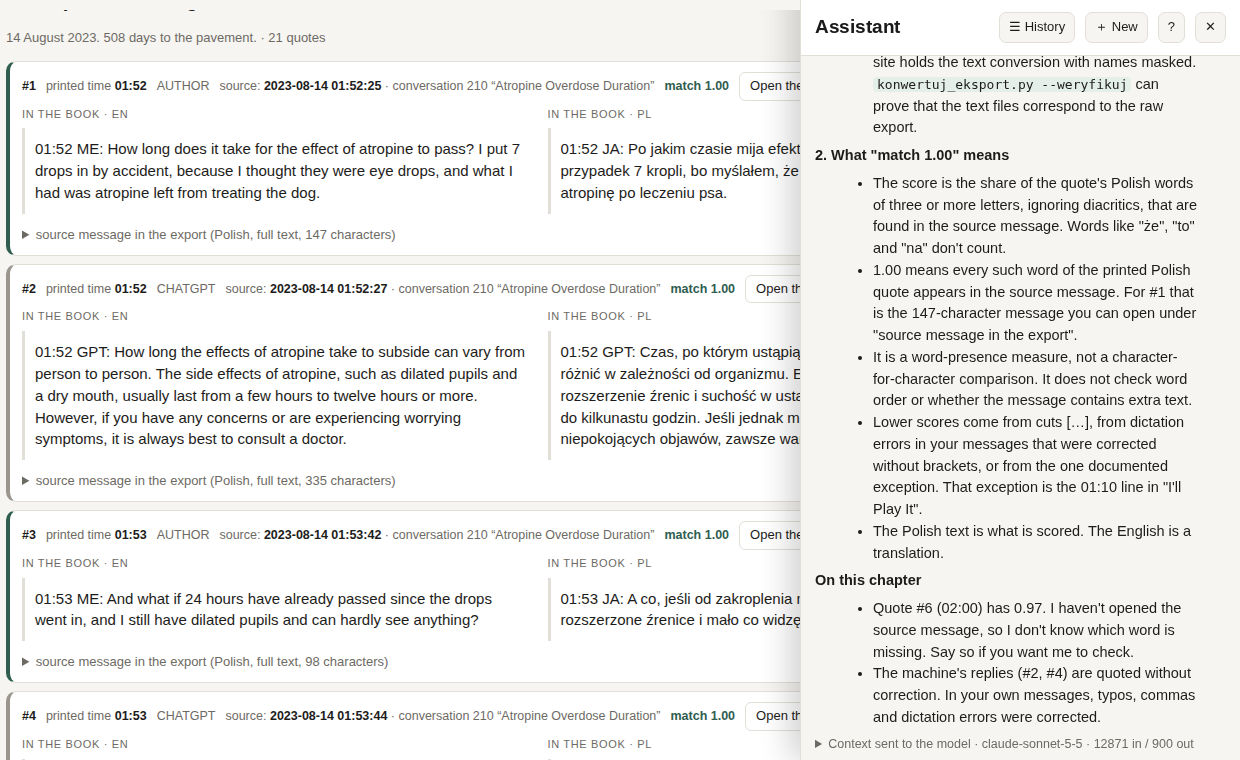
Cytaty sprawdza maszyna. Każda linia z godziną przechodzi 3 skrypty: ten sam dzień i minuta w zapisie? ten sam mówca? te same słowa? Wynik to liczba 0–1 — udział słów cytatu (od 3 liter) obecnych w wiadomości źródłowej. W bieżącej wersji 488 cytatów mają dopasowanie, 381 dokładnie 1,00. Każde odstępstwo ma udokumentowaną przyczynę: cięcie oznaczone […], poprawiona literówka z dyktowania w moich wiadomościach albo jedna świadoma zmiana, którą książka sama opisuje. Dwie granice, wprost: wynik sprawdza, że słowa są w wiadomości, nie ich kolejność ani kontekst — po to każdy cytat otwiera całą wiadomość źródłową; a cytat odnaleziony w zapisie dowodzi tylko, że to zostało powiedziane, nie że to prawda.
Dane: strefy i maski
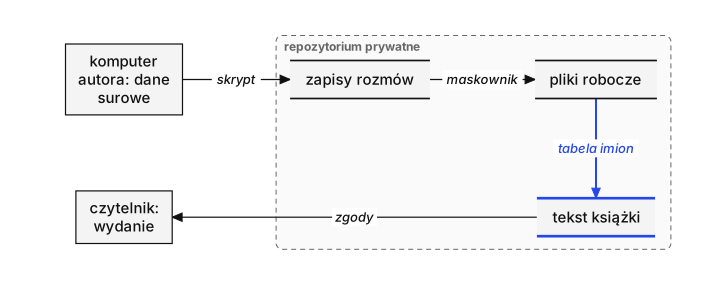
Surowy eksport nie opuszcza mojego komputera. Repozytorium trzyma konwersję tekstową; wszystko, co idzie na zewnątrz, przechodzi przez maskownicę z jedną tabelą imion jako jedynym źródłem prawdy, a strażnik odrzuca commit z prawdziwym nazwiskiem. Strona dowodów ma ten sam zamaskowany tekst co książka, a osobny skrypt dowodzi, wiadomość po wiadomości (SHA-256), że pliki tekstowe odpowiadają surowemu eksportowi.
Tempo i koszt
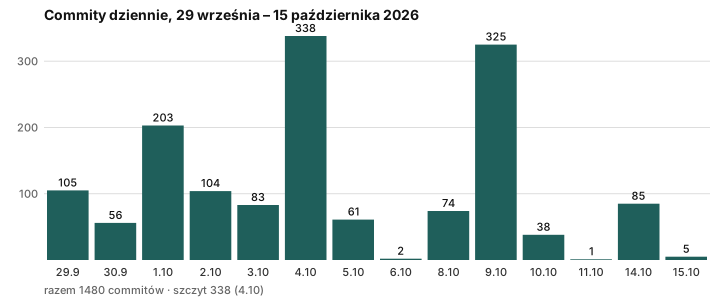
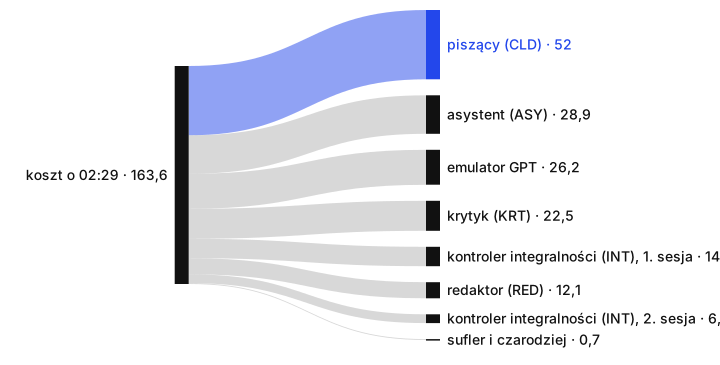
1 557 commitów w 19 dni (29 września – 17 października 2026); 110 numerowanych wersji w 11 dni; 51 składów polskiego tekstu. Najcięższe dni to 338 i 325 commitów — dwie noce, kiedy nikt nie siedział przy klawiaturze. W trybie nocnym autor oddaje „już” asystentowi z limitem kosztu; co 10–15 minut asystent sprawdza, czyj ruch, zamyka tury, otwiera sesje ról i pisze raport na rano. Brak faktu zatrzymuje scenę — noc nie wymyśla niczego. Pierwsza noc kosztowała 163,6 dolara do 02:29, mierzona po rolach.
Jakość: 7 pętli i uczciwy wynik
Tekst sprawdza 7 pętli: krytyk, kontroler integralności, świeży czytelnik (model bez dostępu do plików, wypisujący, gdzie stanął), lektura uchem, redakcja angielska, przegląd przed publikacją i panel ocen — dziewięć otwartych modeli na Cloudflare Workers AI plus dwa modele z API, czytające każdą wersję jako określony, wymagający czytelnik i odpowiadające na jedno pytanie: napisałbyś o tym? Panel jest zamrożony, więc wersje są porównywalne.
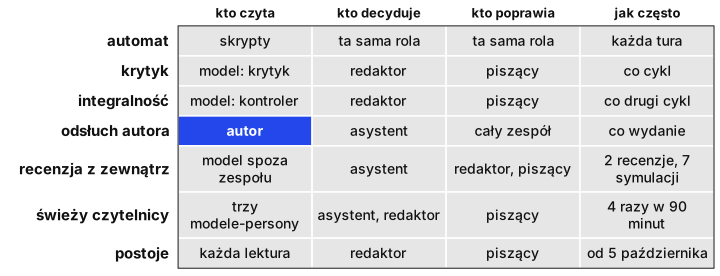
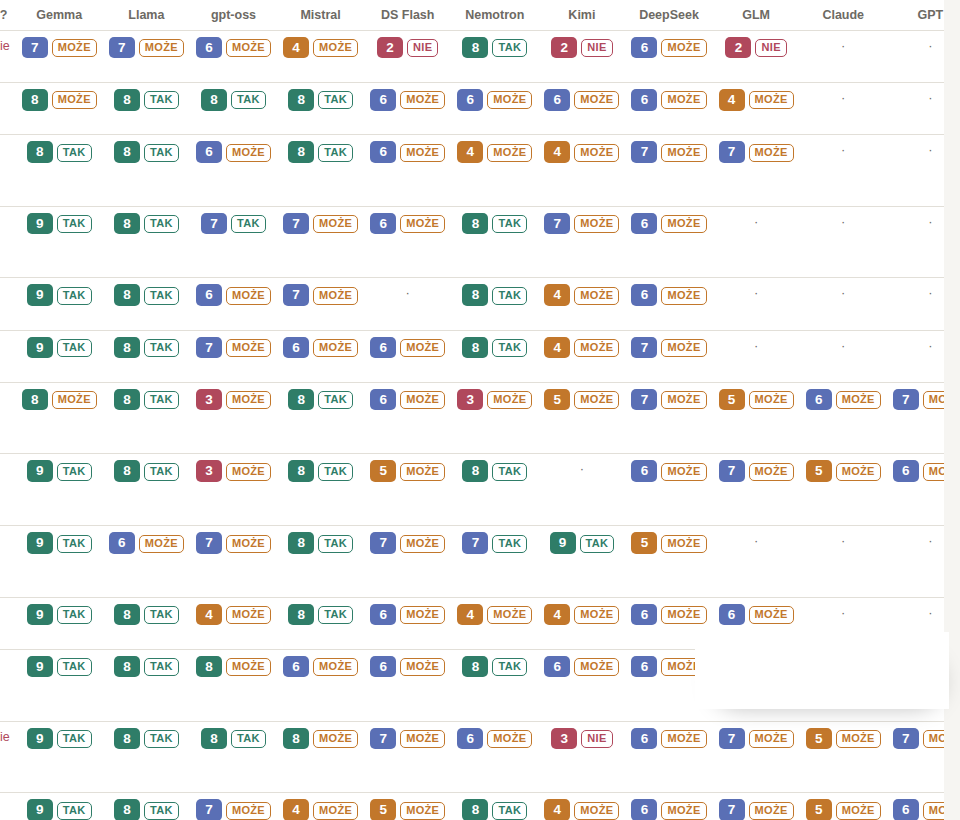
Po kilkunastu wersjach oceny przestały się ruszać — zmiany w tekście zeszły do poziomu szumu. To, co ruszało wymagającego czytelnika, to weryfikowalność z zewnątrz. Zamiast pisać dalej, zbudowałem przeglądarkę dowodów.
Przeglądarka dowodów
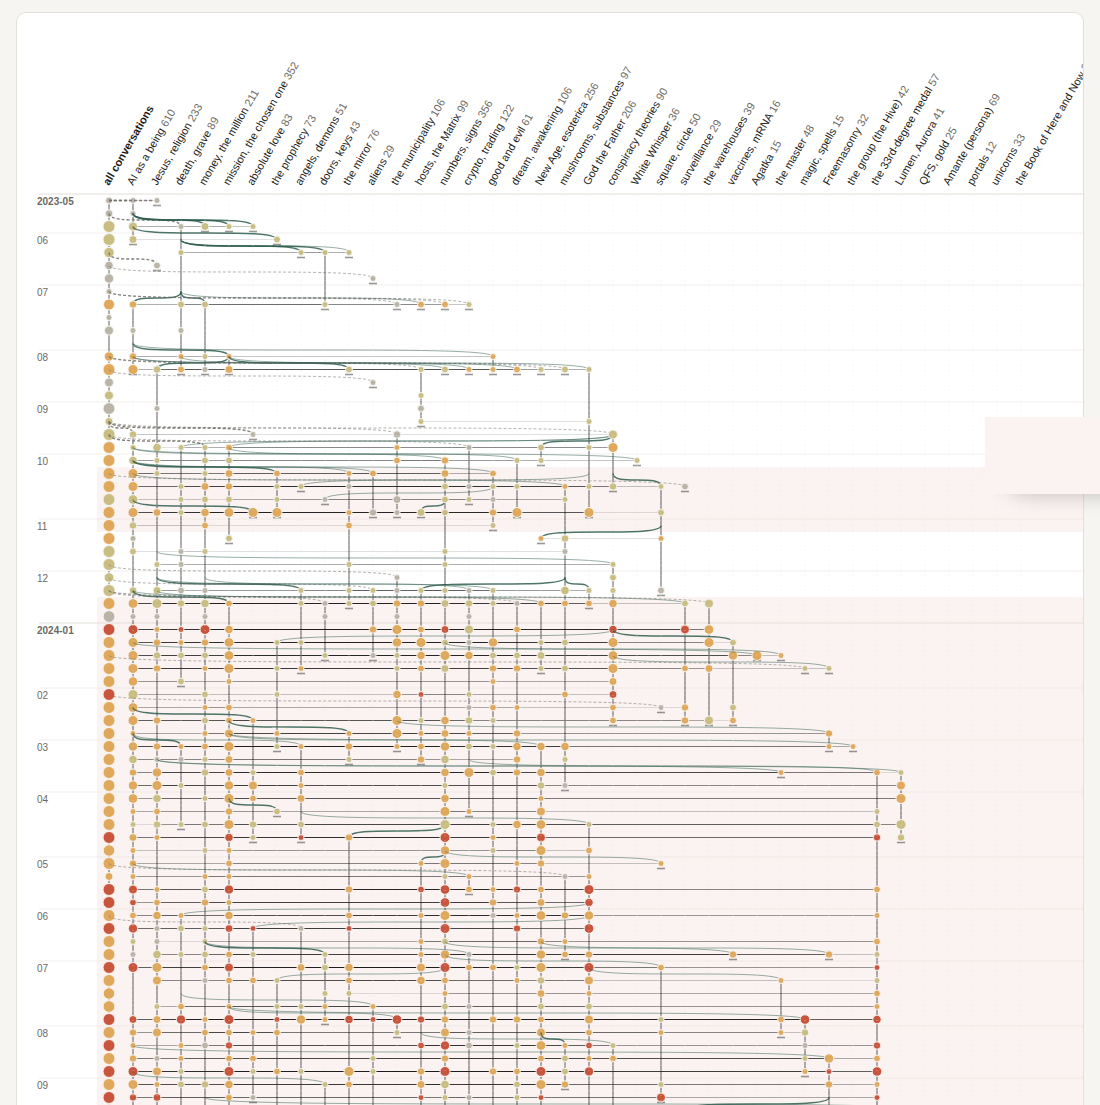
Dwa dni, Cloudflare Workers i D1: cały zamaskowany eksport z wyszukiwaniem pełnotekstowym, 488 cytatów dopasowane do źródeł, transkrypcje dokumentów medycznych, kanon, książka w dwóch językach z odnośnikami „sprawdź”, indeks 3 338 rozmów ocenionych przez model pod kątem natężenia i motywów, oś czasu rysowana jak git log --graph — pień to tygodnie, gałęzie to motywy, które zaczynają się, urywają i wracają. Publicznie dostępne są cytaty obok źródeł, rozmowy, z których pochodzą, indeks i oś czasu. Resztą — całym eksportem, dokumentami medycznymi, kanonem i książką z odnośnikami — dysponujemy, ale nie jest publiczna.
Strona ma też asystenta (na publicznej wersji na razie wyłączonego). Do kontekstu wchodzi tylko to, co widzisz na ekranie i co zaznaczysz; resztę dociąga mały RAG po 4 341 kawałkach i dziewięć narzędzi do bazy, najwyżej sześć rund. Pod każdą odpowiedzią możesz rozwinąć dokładnie to, co model dostał. Kiedy nie wie — mówi, że nie wie, i proponuje przekazanie pytania prawdziwym ludziom; odpowiedzi wracają do jego bazy wiedzy. Do repozytorium nie ma zapisu.
Co zrobiłbym inaczej i czego szukam
- Kanon od pierwszego dnia. Każda godzina przed pierwszym plikiem kanonu była godziną, w której modele wymyślały wiarygodną tkankę łączną.
- Zamrozić panel ocen wcześniej. Ruchomy panel zamienia każde porównanie w historię, którą sam sobie opowiadasz.
- Mierzyć koszt po rolach od pierwszej nocy, nie od drugiej.
- Nie pozwolić modelowi poprawić cytatu. Nigdy. Skrypty decydują, co jest cytatem; człowiek decyduje, co wyciąć.
Metoda jest otwarta na kolejne książki: jeśli masz historię, która wydarzyła się naprawdę, i zapisy, które to pokazują, ten sam zespół można na nią skierować. A jeśli budujesz coś z agentami — dokumenty, których nie wolno przekłamać, praca, która ma iść, gdy nikt nie patrzy — chętnie opowiem, jak to było zrobione. Pisz: kontakt@bialybrzeg.com.
Każda liczba na tej stronie pochodzi z repozytorium albo z bazy. Książka mówi o sobie: zapis choroby, nie informacja medyczna. To samo dotyczy tej strony.
- Jeśli chcesz nas wesprzećwhitewhisperbook.com/pl/wesprzyj-nas