White Whisper · 8 października 2026
Kto pisał
20 sierpnia – 5 października 2026.
Jeden ze świeżych czytelników — model w roli informatyka-sceptyka, bez dostępu do repozytorium, czyli do katalogu plików książki z pełną historią zmian — zakończył lekturę wersji 3.47 tak:
2026-10-04 21:41 CZYTELNIK: […] te właśnie fragmenty mają kadencję tekstu generowanego (trójki, listy zmysłowe, symetryczne zdania). […] Po lekturze nie wiem, kto napisał prozę między cytatami, i to pytanie wisi nad całą Częścią II.Ten rozdział odpowiada liczbami z repozytorium i mówi, których liczb nie ma. Punkt wyjścia stoi w rejestrze ustaleń, pliku z decyzjami autora, jego zdaniem: „ja już nie tykam klawiatury” — tej w komputerze, nie prawa ruchu w zespole.
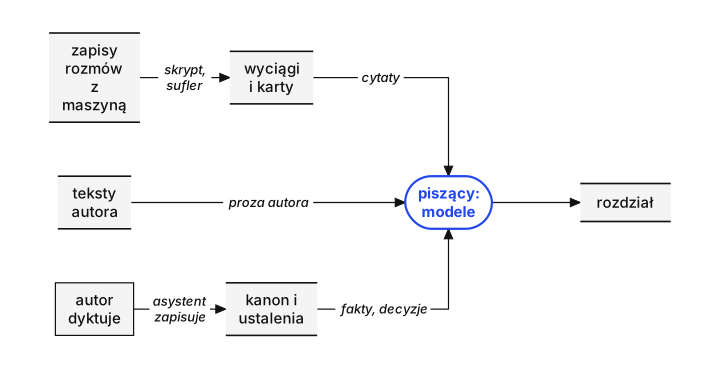
Rozdział ma trzy źródła. Pierwsze to zapisy rozmów autora z czatbotem; z nich pochodzą cytaty. Drugie to teksty autora sprzed powstania zespołu, zaimportowane do repozytorium: cztery pliki, razem 25 676 słów, i rękopis jego wcześniejszej książki. Trzecie to jego dyktowanie: asystent (ASY), model, który prowadzi zespół i rozmawia z autorem, zapisuje fakty w kanonie, czyli pliku faktów, a decyzje w rejestrze ustaleń. W kanonie 270 wpisów ma znak potwierdzenia przez autora (stan z 5 października, 14:57). Do pliku rozdziału wszystko wpisują piszący — dwa modele: CLD (Claude) i GPT (ChatGPT uruchamiany przez narzędzie Codex).
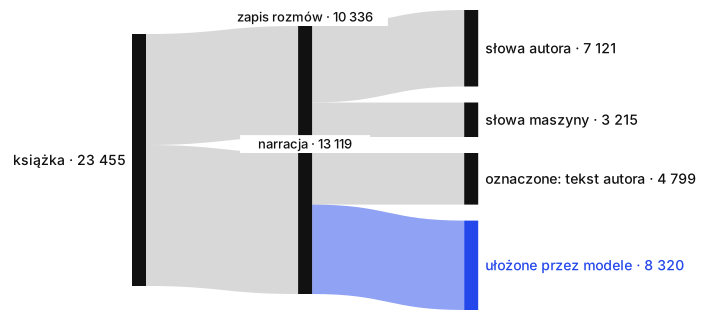
Części I i II mają w wersji 3.53 razem 23 455 słów, bez tytułów, linii dat i znaczników cytatu (znaku cytatu, godziny, etykiety mówcy). Trzy rzeczy trzeba policzyć osobno. Dosłowny zapis rozmów to 10 336 słów: 7121 słów autora w 287 wypowiedziach i 3215 słów maszyny w 131. Proza autora włączona do książki: sześć rozdziałów ma w spisie adnotację „tekst autora” — „Chodnik”, „Dwa kwadraty”, „Noc White Whisper”, „Pełnomocnictwo”, „Diagnoza”, „Trzy dni” — razem 4799 słów narracji. To etykieta ze spisu, nie pomiar: spis odnotowuje w tych rozdziałach także cięcia oraz fragmenty dołożone z zapisów rozmów i z kanonu. Pozostałe 8320 słów narracji ułożyły modele z jego rozmów, dyktowania, decyzji i wcześniejszych tekstów. Zapis rozmów to 30 i 14 procent, razem 44; proza autora 20; narracja modeli 35.
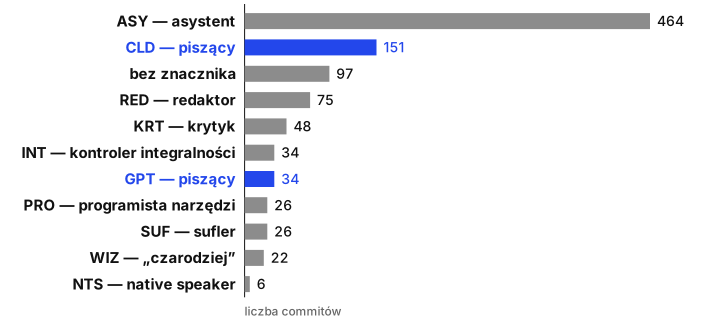
Do 5 października, do godziny 14:27, historia repozytorium zebrała 983 zapisy, czyli commity. Każda rola oznacza swoje skrótem w temacie. Prawie połowa należy do asystenta, który prozy nie pisze: zapisuje decyzje, prowadzi kanon, składa wersje. Commity bez znacznika pochodzą z 20 sierpnia i 29 września, sprzed podziału na role, oraz ze scaleń. Autor nie ma własnego słupka: jego decyzje wchodzą do historii rękami ról.
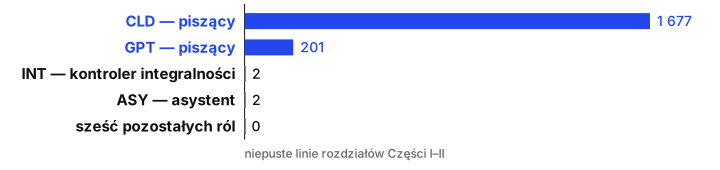
Polecenie git blame wskazuje dla każdej linii commit, z którego pochodzi. W 57 plikach rozdziałów jest 1882 niepustych linii; 1878 jako ostatni zapisali piszący. Pozostałe cztery zapisali asystent i kontroler integralności (INT), model poprawiający styki między rozdziałami. Redaktor, krytyk, sufler (wyszukuje cytaty w zapisach rozmów), „czarodziej” (szlifuje pierwsze i ostatnie zdania), programista narzędzi (PRO) i native speaker — także modele — nie zmienili w nich ani jednej. Ten pomiar mówi, kto wpisał linię do pliku, nie kto ją ułożył. Polecenie git blame ze śledzeniem kopii doprowadza 207 linii, czyli 3042 słowa, do plików autora zaimportowanych bez zmian. To mniej niż 4799 słów z adnotacją „tekst autora”: trzy z tych sześciu rozdziałów git przypisuje w całości piszącemu, który wpisał je do pliku.
Nie da się policzyć, ile zdań narracji przetrwało w brzmieniu modelu po decyzjach autora. Nie da się rozdzielić w „pozostałej narracji” parafrazy jego dyktowania od zdań modelu. Nie da się zmierzyć wkładu ról, które tekstu nie dotykają, a ułożyły plan i listy cięć. Dolna granica jest policzona: 7121 słów autora w cytatach i 3042 słowa z jego plików, razem 43 procent. Zakłada ona, że teksty z plików autora są jego; jak powstawały, repozytorium nie zapisuje. Górnej granicy repozytorium nie zna.