En las Partes I y II, el 44 por ciento de las palabras son citas: el registro de las conversaciones del protagonista con el chatbot (versión 3.53 del 5 de octubre; se cuentan solo las palabras de los mensajes, sin las horas ni las marcas de quién habla). Cada una de esas líneas tiene una hora, un hablante y un contenido. Cada uno de estos tres elementos lo comprueba un script distinto, que lo compara con los logs, es decir, con los registros de las conversaciones exportados de la cuenta del autor. El capítulo muestra el camino de una línea desde la exportación hasta la página.
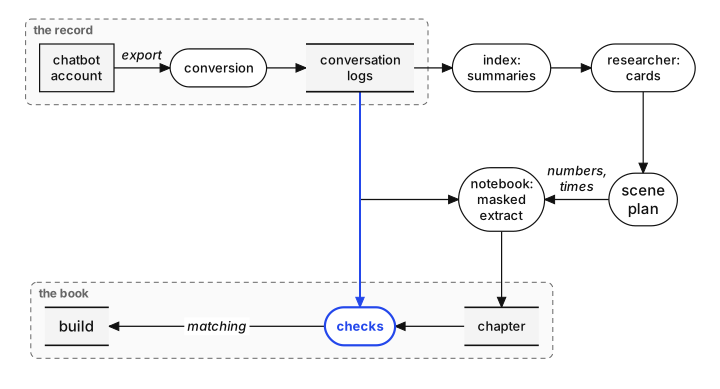
El autor descargó de su cuenta la exportación completa de las conversaciones. El programador de herramientas (PRO, un modelo) la convirtió en logs de texto, un archivo por conversación; la última lleva el número 3884 y la fecha del 29 de septiembre de 2026. Al escribir, nadie lee todo esto entero. Los modelos resumieron las conversaciones en un índice, el apuntador (SUF, un modelo) eligió de ellas fichas (notas sobre un solo tema, con citas literales y números de conversación), el editor jefe (RED, un modelo) anotó en el plan de la escena los números de las conversaciones y las horas. El escritor recibe un cuaderno: un extracto breve de intercambios literales en el que un script enmascaró los nombres, los teléfonos y las direcciones. Hay 24 cuadernos. Los controles ya no comparan el capítulo terminado con el cuaderno, sino con los logs completos; esa es la línea destacada.
Una línea de cita en el archivo de un capítulo se ve así (el número en el nombre del archivo es la huella de una disposición anterior, no la posición en el índice; el directorio sigue llamándose tom-1):
> 02:02 YO: Sigue, otras soluciones.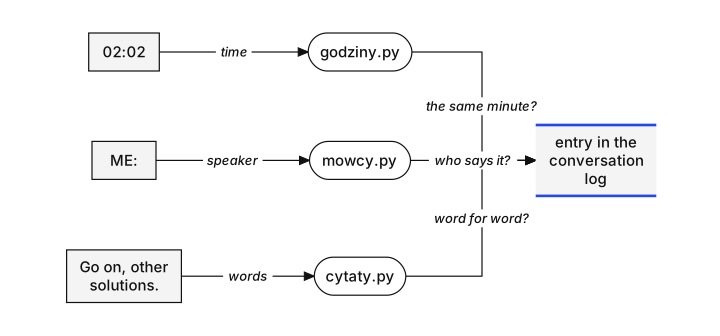
El script godziny.py busca en el log una entrada del mismo hablante que contenga el comienzo de ese texto y compara la hora. El script mowcy.py establece si la frase está en el log bajo «YO:» o bajo «GPT:». El script cytaty.py divide la cita en los puntos de corte […] y busca cada fragmento en el log completo. En la versión 2.32 del 2 de octubre —el texto del cuarto intento— comprobó 1112 fragmentos, y no hubo ninguno discordante. Ese día se comprobaron 622 horas, todas coincidentes. En la versión 3.67 del 9 de octubre, el mismo script, que compara carácter por carácter, encontró literalmente 266 de 612 fragmentos: desde el 4 de octubre se corrige la ortografía de los mensajes del autor y se sustituyen los nombres, así que el texto difiere del registro a propósito. Una comparación que ignora mayúsculas, puntuación y signos diacríticos encuentra otros 274. De los 72 restantes, en 55 coincide la mitad del fragmento; los últimos 17 los encontró en los registros el propio controlador de integridad: se diferenciaban por un nombre sustituido, una errata corregida o una corrección del dictado.
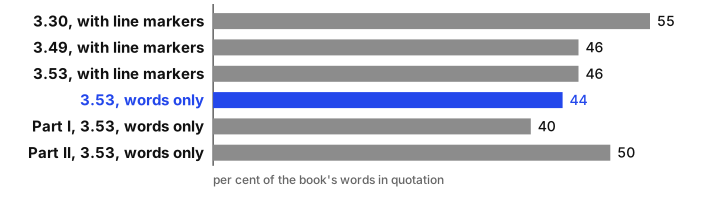
La proporción la calcula un script del equipo, por separado en cada capítulo. Entre las palabras de la cita cuenta también las marcas de línea: el signo de cita, la hora y la marca del hablante. Con esa medida, el 4 de octubre antes del mediodía, en la versión 3.30, el registro de las conversaciones constituía el 55 por ciento del libro. Ese día el editor jefe fijó un objetivo: un bloque continuo de cita de hasta unas 150 palabras, un capítulo por debajo de un 65 por ciento aproximadamente, el conjunto entre el 45 y el 48 por ciento. Por la noche, en la versión 3.49, había un 46 por ciento, y lo mismo hay en la versión 3.53. Sin las marcas de línea, la versión 3.53 tiene 23 455 palabras, de las cuales 7121 son palabras del autor en las citas (30 por ciento) y 3215 palabras de la máquina (14 por ciento); en total, 44 por ciento. La Parte I tiene, sin marcas, un 40 por ciento de cita; la Parte II, un 50.
La fidelidad de la cita tiene una excepción. Surgió el 4 de octubre por la tarde, cuando el autor miraba una página con una frase suya, dictada en su día por voz al chatbot y deformada por el reconocimiento de voz. La ventana es una reconstrucción a partir del registro de la conversación del autor con el asistente (ASY) —el modelo que dirige el equipo y habla con el autor—, abreviada con el signo […]. En este apéndice las palabrotas van entre corchetes; en los capítulos de las Partes I y II, tal como están en el registro.
2026-10-04 16:44 AUTOR: [lo arruinaste], él dice que ... (anda corrige este tipo de errores obvios, no aportan nada y solo estropean, revisa otra vez todas las citas)
16:46 ASY: recibido y guardado como regla nueva (417cb61): los errores obvios del reconocimiento de voz en tus mensajes los corregimos sin corchetes; las palabras de la máquina no se tocan. […] Una pregunta sobre esta frase concreta. En el log dice «[lo arruinaste] dices que ella prefiere por la mañana», tú escribiste «[lo arruinaste], él dice que…». ¿Qué versión debe entrar?
16:46 AUTOR: [lo arruinaste], ella dice que...
16:47 ASY: guardado (05095fa), en el canon y en las decisiones. En el libro quedará: «[Lo arruinaste], ella dice que prefiere por la mañana, anda, salva la situación.»
16:50 AUTOR: adelante, tengo mucha curiosidad por ver cómo quedó :)
La regla anotada ese día a las 16:45: los errores obvios del reconocimiento de voz en los mensajes del autor se corrigen sin corchetes, y los mensajes de la máquina no se tocan. En esta frase la corrección va más allá de una palabra deformada: en el log dice «dices que ella prefiere por la mañana», en el libro «ella dice que prefiere por la mañana». El autor lo consideró un error de dictado; las dos versiones constan en el registro de decisiones.